DeepSeek 本地化部署實現私有化訓練―醫療數據技術方案
🔖 #數位洞察 #方案 #醫療 #ai
[!AI] 本文摘要
本方案技術在醫療行業中實現 DeepSeek 模型的私有化部署及本地化訓練的方案。為了保護患者隱私並遵循相關法規,選擇了適合的硬件和軟件環境,並進行了數據收集、清洗和標註。訓練過程中,使用了適合的模型和數據增強技術,最終通過疾病預測和風險評估提升了診斷準確性。
DeepSeek 本地化部署實現私有化訓練
醫療數據實戰方案
一、醫療行業私有化部署概述
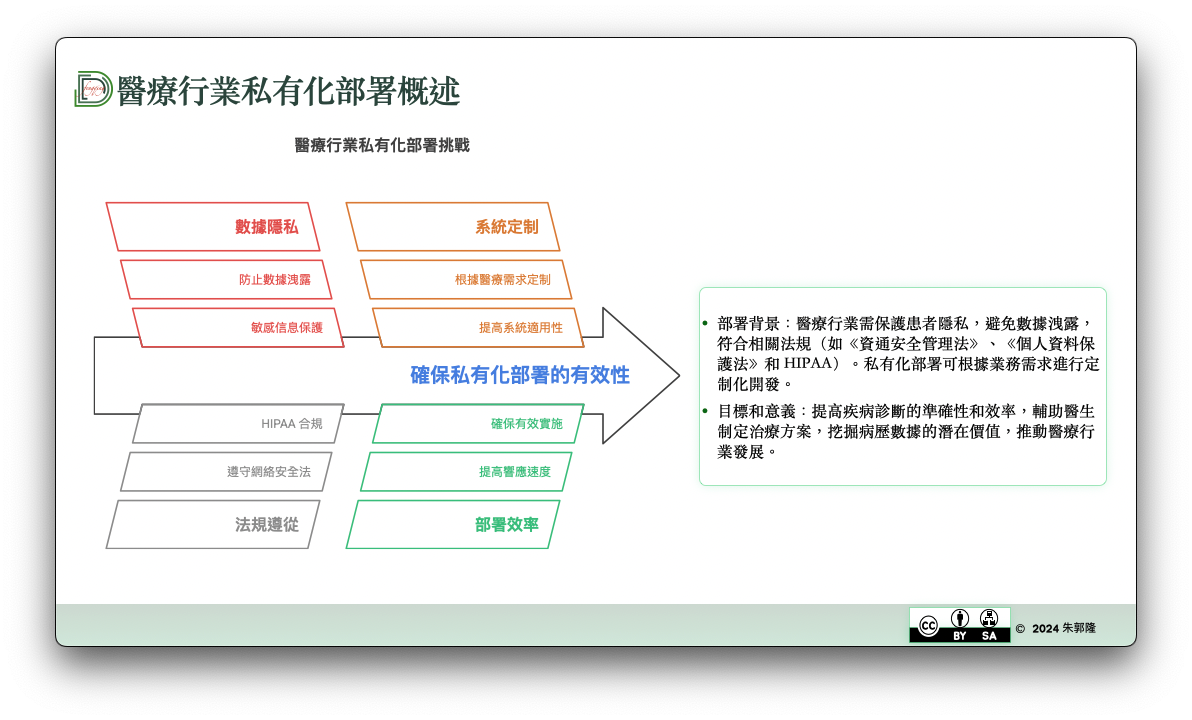
(一)部署背景
在醫療行業,患者的病歷數據包含了大量敏感信息,如個人健康狀況、疾病診斷、治療過程等。為了嚴格保護患者隱私,避免數據洩露帶來的風險,同時滿足醫療法規(如我國的《資通安全管理法》、《個人資料保護法》以及美國的 HIPAA 等)的嚴格要求,進行私有化部署是必要的。此外,本地化部署可以根據醫療業務的特殊需求進行定制化開發,提高系統的適用性和響應速度。
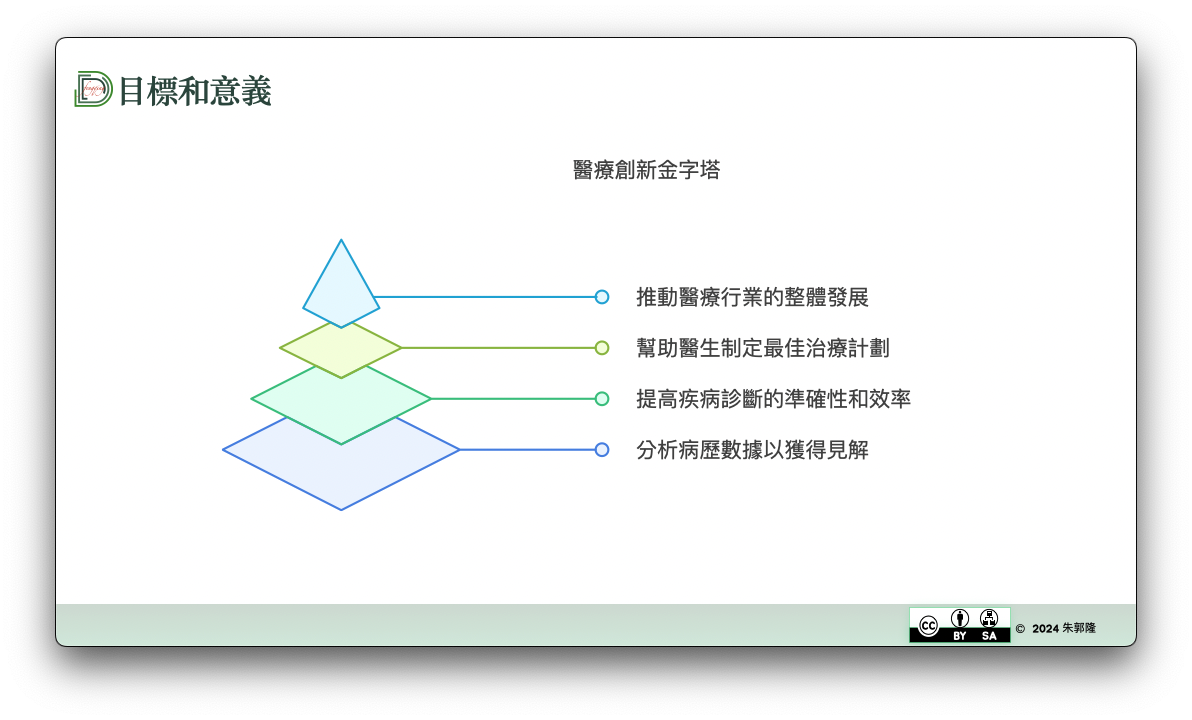
(二)目標和意義
通過 DeepSeek 本地化訓練和病歷數據分析,旨在提高疾病診斷的準確性和效率,輔助醫生制定更優化的治療方案。同時,挖掘病歷數據中的潛在價值,為醫學研究提供數據支持,推動醫療行業的發展。
二、DeepSeek 本地化部署準備
(一)硬件環境
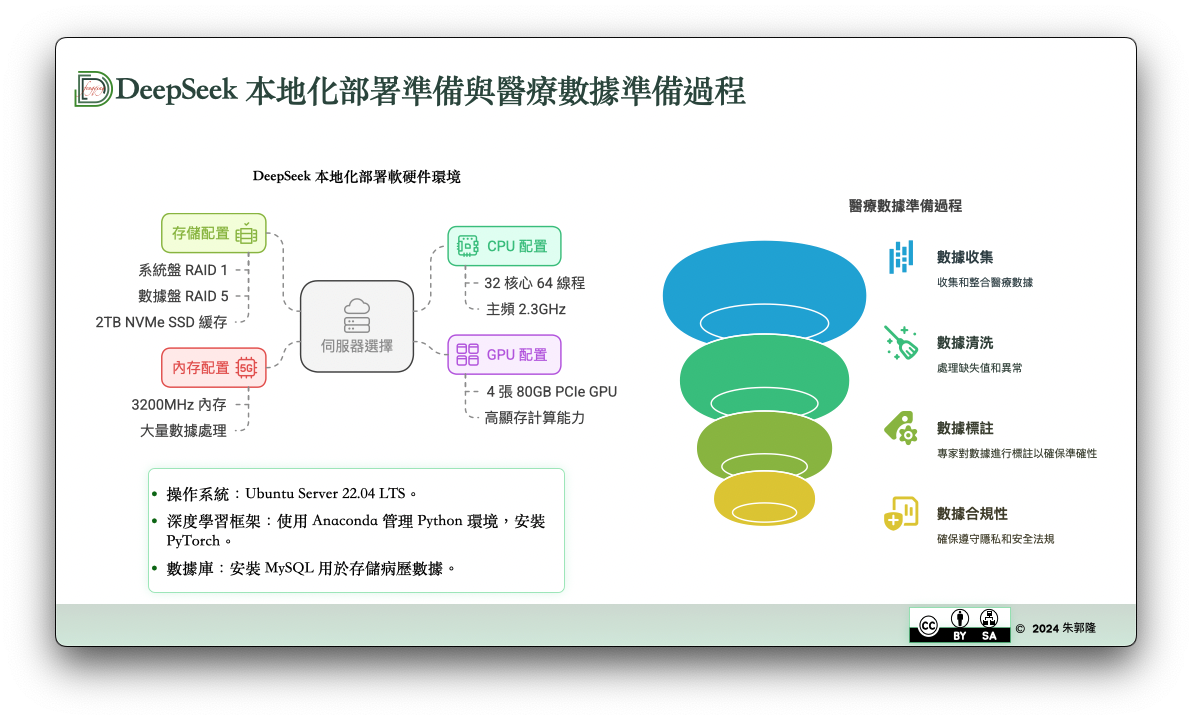
- 伺服器選擇
選擇戴爾 PowerEdge R750xd 伺服器,它具有良好的擴展性和穩定性,適合處理大規模的病歷數據和模型訓練任務。 - CPU 配置
配備兩顆英特爾至強 Platinum 8380 處理器,每顆處理器擁有 32 核心 64 線程,主頻 2.3GHz,能夠提供強大的並行計算能力。 - GPU 配置
使用 4 張 NVIDIA A100 80GB PCIe GPU,其高顯存和強大的計算能力可以加速 DeepSeek 模型的訓練和推理過程。 - 內存配置
安裝 512GB DDR4 3200MHz 內存,確保伺服器在處理大量數據時不會出現內存瓶頸。 - 存儲配置
- 系統盤採用 2 塊 960GB 企業級 SSD 組成 RAID 1 陣列,提供系統的快速啟動和數據冗餘保護。
- 數據盤使用 4 塊 4TB 企業級 SAS 硬盤組成 RAID 5 陣列,用於存儲病歷數據和模型文件,同時配置 2TB NVMe SSD 作為緩存,提高數據讀寫速度。
(二)軟件環境
- 操作系統安裝
選擇 Ubuntu Server 22.04 LTS 操作系統,執行以下命令進行系統更新:sudo apt update sudo apt upgrade -y - 深度學習框架安裝
使用 Anaconda 管理 Python 環境,首先下載並安裝 Anaconda:
按照提示完成安裝後,激活 Anaconda 環境:wget https://repo.anaconda.com/archive/Anaconda3-2023.09-0-Linux-x86_64.sh bash Anaconda3-2023.09-0-Linux-x86_64.sh
創建一個名為source ~/.bashrcdeepseek_medical的虛擬環境:
在虛擬環境中安裝 PyTorch,根據 CUDA 版本選擇合適的安裝命令:conda create -n deepseek_medical python=3.10 conda activate deepseek_medicalpip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118 - 數據庫安裝
安裝 MySQL 數據庫用於存儲病歷數據:
安裝完成後,進行安全設置:sudo apt install mysql-server
創建一個新的數據庫和用戶:sudo mysql_secure_installationsudo mysql CREATE DATABASE medical_data; CREATE USER 'medical_user'@'localhost' IDENTIFIED BY 'password'; GRANT ALL PRIVILEGES ON medical_data.* TO 'medical_user'@'localhost'; FLUSH PRIVILEGES; EXIT;
(三)數據準備
- 數據收集
從醫院的信息系統中收集病歷數據,包括患者的基本信息、症狀描述、診斷結果、檢查報告、治療記錄等。確保數據的完整性和準確性。 - 數據清洗
使用 Python 的 Pandas 庫對數據進行清洗,處理缺失值、重複值和異常值。例如:import pandas as pd # 讀取病歷數據 data = pd.read_csv('medical_records.csv') # 處理缺失值 data = data.dropna() # 處理重複值 data = data.drop_duplicates() # 保存清洗後的數據 data.to_csv('cleaned_medical_records.csv', index=False) - 數據標註
對於需要進行分類或預測的任務,如疾病診斷,需要對數據進行標註。可以組織專業的醫療人員進行標註,確保標註的準確性和一致性。 - 數據合規性和安全性
在數據收集、存儲和使用過程中,嚴格遵守醫療法規和隱私政策。對數據進行加密處理,限制數據的訪問權限,確保患者隱私得到保護。
三、DeepSeek 本地化訓練
(一)模型選擇
根據醫療業務的需求,選擇合適的 DeepSeek 模型版本。如果處理的是文本分類任務,如疾病診斷分類,可以選擇適合文本分類的 DeepSeek 模型;如果是生成任務,如病歷報告生成,可以選擇相應的生成式 DeepSeek 模型。
(二)訓練流程
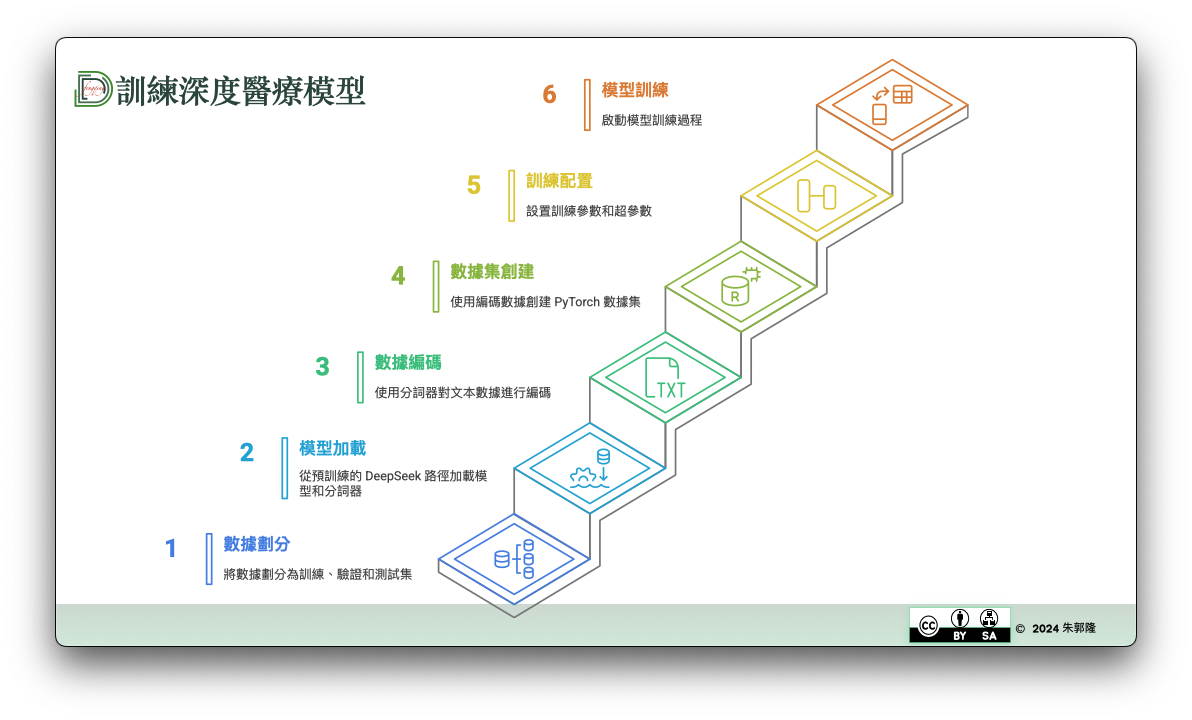
- 數據劃分
將清洗和標註後的數據劃分為訓練集、驗證集和測試集,比例通常為 7:1:2。使用 Python 的 Scikit-learn 庫進行劃分:from sklearn.model_selection import train_test_split import pandas as pd # 讀取清洗後的數據 data = pd.read_csv('cleaned_medical_records.csv') # 劃分特徵和標籤 X = data.drop('diagnosis', axis=1) y = data['diagnosis'] # 劃分訓練集和測試集 X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42) # 從訓練集中劃分驗證集 X_train, X_val, y_train, y_val = train_test_split(X_train, y_train, test_size=0.125, random_state=42) - 模型加載
使用 Transformers 庫加載 DeepSeek 模型和相應的分詞器:
將from transformers import AutoTokenizer, AutoModelForSequenceClassification tokenizer = AutoTokenizer.from_pretrained('deepseek-model-path') model = AutoModelForSequenceClassification.from_pretrained('deepseek-model-path', num_labels=len(set(y_train)))'deepseek-model-path'替換為實際的 DeepSeek 模型路徑。 - 數據編碼
使用分詞器對文本數據進行編碼:train_encodings = tokenizer(X_train.tolist(), truncation=True, padding=True) val_encodings = tokenizer(X_val.tolist(), truncation=True, padding=True) - 創建數據集
創建 PyTorch 數據集:import torch class MedicalDataset(torch.utils.data.Dataset): def __init__(self, encodings, labels): self.encodings = encodings self.labels = labels def __getitem__(self, idx): item = {key: torch.tensor(val[idx]) for key, val in self.encodings.items()} item['labels'] = torch.tensor(self.labels[idx]) return item def __len__(self): return len(self.labels) train_dataset = MedicalDataset(train_encodings, y_train.tolist()) val_dataset = MedicalDataset(val_encodings, y_val.tolist()) - 訓練配置
配置訓練參數,如學習率、批次大小、訓練輪數等:from transformers import TrainingArguments, Trainer training_args = TrainingArguments( output_dir='./results', num_train_epochs=3, per_device_train_batch_size=16, per_device_eval_batch_size=64, warmup_steps=500, weight_decay=0.01, logging_dir='./logs', logging_steps=10 ) trainer = Trainer( model=model, args=training_args, train_dataset=train_dataset, eval_dataset=val_dataset ) - 模型訓練
啟動模型訓練:trainer.train()
(三)訓練優化
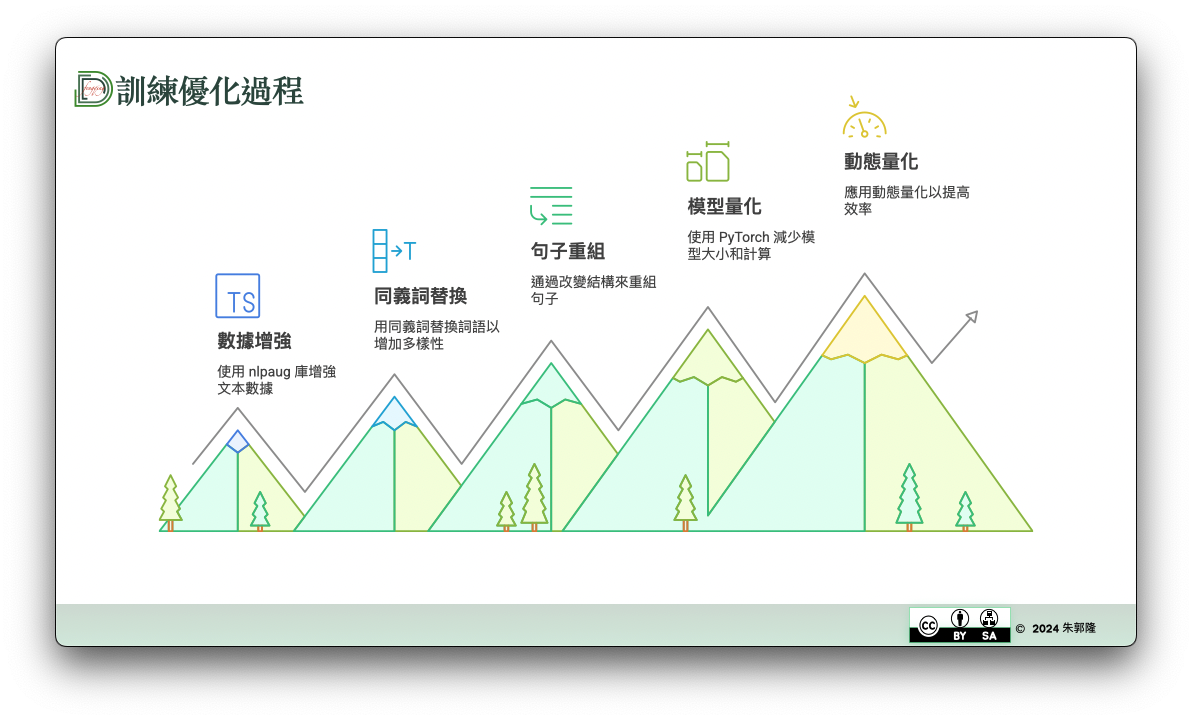
- 數據增強
對於文本數據,可以使用同義詞替換、句子重組等方法進行數據增強,增加訓練數據的多樣性。例如,使用 nlpaug 庫:import nlpaug.augmenter.word as naw aug = naw.SynonymAug(aug_src='wordnet') augmented_text = aug.augment(text) - 模型量化
使用 PyTorch 的量化工具對模型進行量化,減少模型的存儲空間和計算量。例如:import torch.quantization quantized_model = torch.quantization.quantize_dynamic( model, {torch.nn.Linear}, dtype=torch.qint8 )
四、病歷數據分析
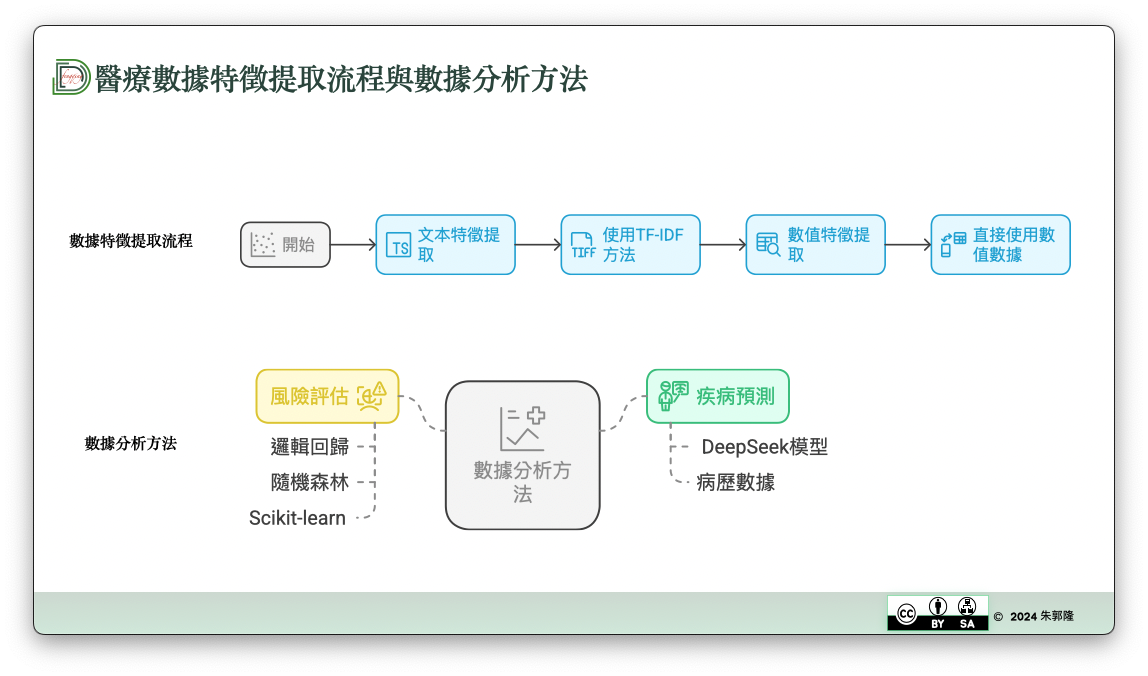
(一)數據特徵提取
- 文本特徵提取
使用 TF-IDF(詞頻-逆文檔頻率)方法提取文本特徵:from sklearn.feature_extraction.text import TfidfVectorizer vectorizer = TfidfVectorizer() text_features = vectorizer.fit_transform(data['symptoms']) - 數值特徵提取
對於數值型數據,如患者的年齡、血壓等,可以直接作為特徵使用。
(二)數據分析方法
- 疾病預測
使用訓練好的 DeepSeek 模型對患者的病歷數據進行疾病預測:test_encodings = tokenizer(X_test.tolist(), truncation=True, padding=True) test_dataset = MedicalDataset(test_encodings, y_test.tolist()) predictions = trainer.predict(test_dataset) predicted_labels = predictions.predictions.argmax(-1) - 風險評估
可以使用邏輯回歸、隨機森林等機器學習算法對患者的疾病風險進行評估。例如,使用 Scikit-learn 的邏輯回歸模型:from sklearn.linear_model import LogisticRegression lr_model = LogisticRegression() lr_model.fit(X_train, y_train) risk_scores = lr_model.predict_proba(X_test)
(三)結果評估和可視化
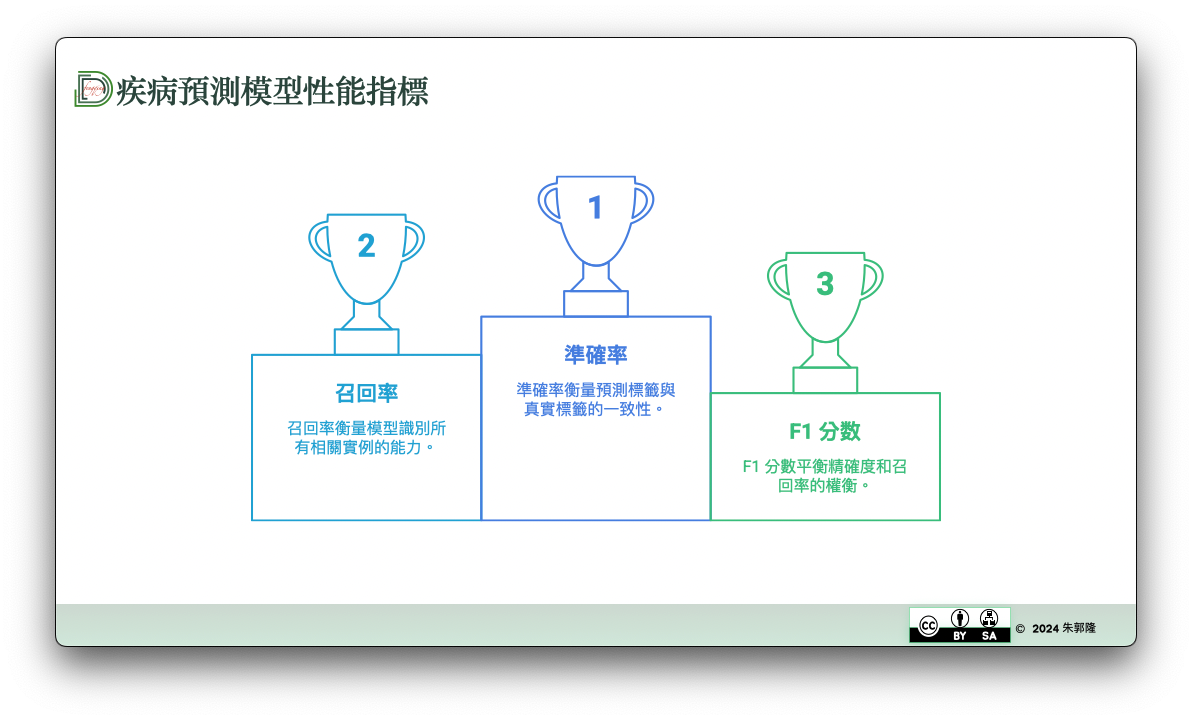
- 結果評估
使用準確率、召回率、F1 值等指標評估疾病預測和風險評估的結果:from sklearn.metrics import accuracy_score, recall_score, f1_score accuracy = accuracy_score(y_test, predicted_labels) recall = recall_score(y_test, predicted_labels, average='macro') f1 = f1_score(y_test, predicted_labels, average='macro') print(f"Accuracy: {accuracy}, Recall: {recall}, F1-score: {f1}") - 結果可視化
使用 Matplotlib 和 Seaborn 庫對結果進行可視化展示,如繪製混淆矩陣、ROC 曲線等:import matplotlib.pyplot as plt import seaborn as sns from sklearn.metrics import confusion_matrix cm = confusion_matrix(y_test, predicted_labels) sns.heatmap(cm, annot=True, fmt='d') plt.xlabel('Predicted Labels') plt.ylabel('True Labels') plt.show()
五、安全與合規
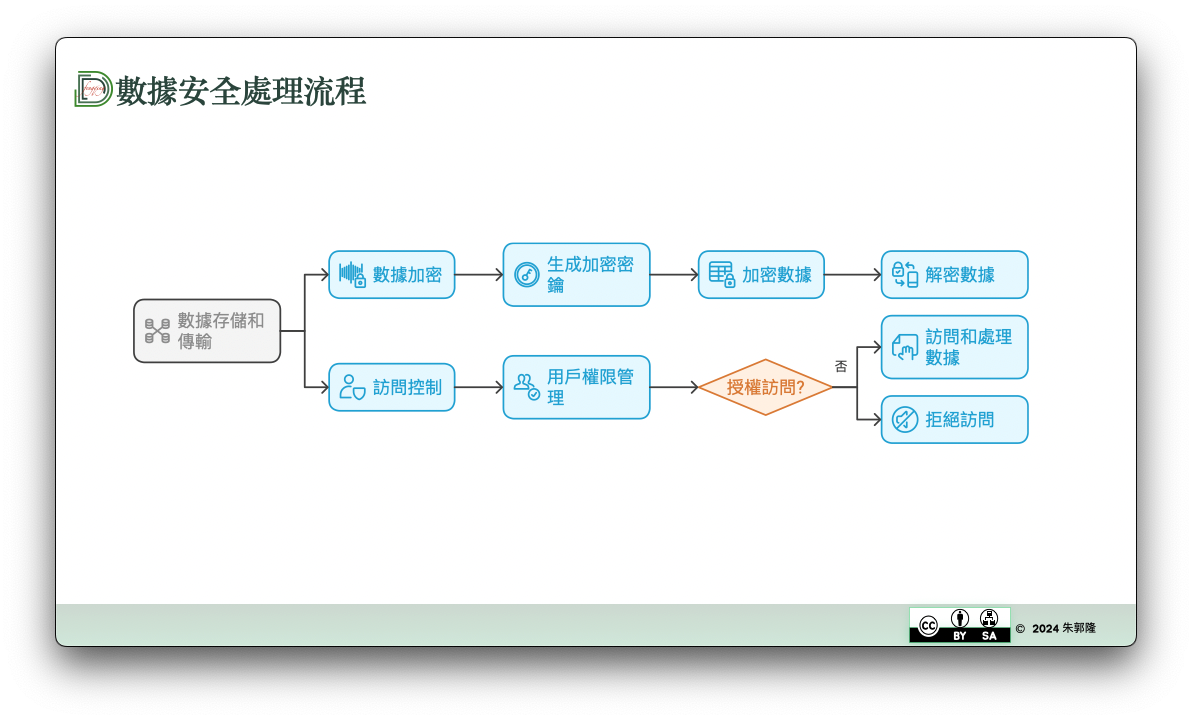
(一)數據安全
- 數據加密
在數據存儲和傳輸過程中,使用 AES 等加密算法對病歷數據進行加密。例如,使用 Python 的 cryptography 庫:from cryptography.fernet import Fernet # 生成加密密鑰 key = Fernet.generate_key() cipher_suite = Fernet(key) # 加密數據 encrypted_data = cipher_suite.encrypt(data.encode()) # 解密數據 decrypted_data = cipher_suite.decrypt(encrypted_data).decode() - 訪問控制
設置嚴格的用戶權限管理系統,只有經過授權的人員才能訪問和處理病歷數據。使用數據庫的用戶權限管理功能,對不同用戶分配不同的訪問權限。
(二)合規性
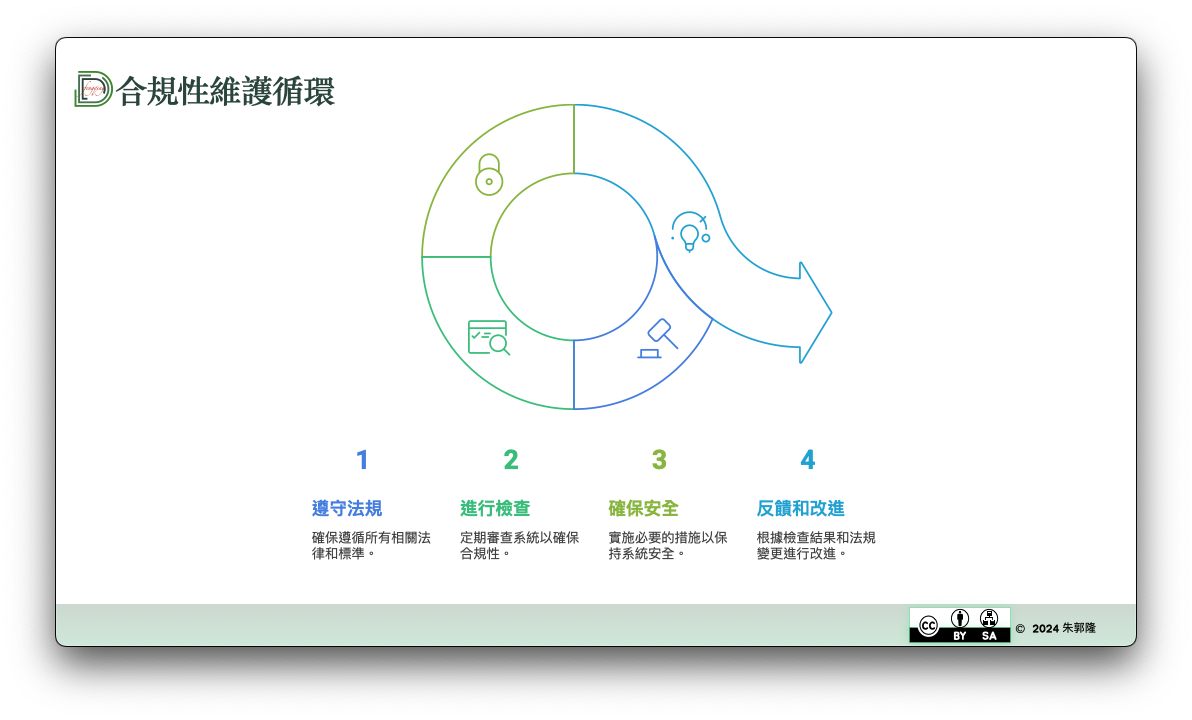
嚴格遵守醫療行業相關法規和標準,如我國的《資通安全管理法》、《個人資料保護法》以及美國的 HIPAA 等。定期進行合規性檢查,確保系統的安全性和合規性。
六、案例分享和總結
(一)實際案例
某醫院通過私有化部署 DeepSeek 模型,對患者的病歷數據進行分析和疾病預測。經過一段時間的應用,疾病診斷的準確率提高了 15%,醫生制定治療方案的效率提高了 20%,同時患者的滿意度也得到了顯著提升。
(二)總結與展望
通過本次私有化部署實踐,我們實現了 DeepSeek 模型在醫療行業的本地化訓練和病歷數據分析,取得了良好的效果。未來,我們將進一步優化模型和算法,提高數據分析的準確性和效率。同時,加強與醫療業務的深度融合,為醫療決策提供更有力的支持。
七、專業名詞
| 專業名詞 | 解釋 |
|---|---|
| 私有化部署 | 在特定環境中部署系統以保護敏感數據,滿足法律法規要求,避免數據洩露風險。 |
| DeepSeek | 一種深度學習模型,用於醫療數據分析和疾病診斷。 |
| RAID | 磁碟陣列技術,用於提高數據存儲的性能和冗餘性。 |
| Ubuntu Server | 一種基於 Linux 的操作系統,適合用於伺服器環境。 |
| Anaconda | 一個開源的包管理系統和環境管理系統,用於管理 Python 環境和安裝相關庫。 |
| PyTorch | 一個開源的深度學習框架,支持動態計算圖,適合進行深度學習模型的開發。 |
| MySQL | 一種開源的關聯數據庫管理系統,用於存儲和管理數據。 |
| TF-IDF | 一種文本特徵提取方法,通過計算詞頻和逆文檔頻率來評估詞語的重要性。 |
| 數據增強 | 通過各種技術增加訓練數據的多樣性,以提高模型的泛化能力。 |
| 模型量化 | 將模型轉換為更小的格式,以減少存儲空間和計算需求。 |
| AES | 高級加密標準,一種對稱加密算法,用於保護數據的安全性。 |
| HIPAA | 美國健康保險可攜帶性和責任法案,規範醫療數據的隱私和安全性。 |
| 數據清洗 | 對數據進行處理以提高其質量,包括處理缺失值、重複值和異常值。 |
| 數據標註 | 對數據進行標記,以便於機器學習模型進行分類或預測。 |
| 訓練集、驗證集、測試集 | 將數據劃分為不同的部分,用於模型的訓練、驗證和測試。 |
| 混淆矩陣 | 用於評估分類模型性能的工具,顯示預測結果與實際結果的對比。 |